Строки как коллекция
На прошлом занятии мы познакомились с коллекцией, которая называется множество. Вспомним, что основная особенность коллекций — возможность хранить несколько значений под одним именем. Можно сказать, что коллекция является контейнером для этих значений.
Но еще до изучения множеств мы уже знали тип данных, который ведет себя подобно коллекции. Этот тип данных — строка. Действительно, ведь строка фактически является последовательностью символов. В некоторых языках программирования есть специальный тип данных char, позволяющий хранить один символ. В Python такого типа данных нет, поэтому можно сказать, что строка — последовательность односимвольных строк.
Что мы знаем о строках
Давайте вспомним, что мы уже знаем о работе со строками в языке Python. Мы умеем создавать строки четырьмя способами:
- задавать напрямую
- считывать с клавиатуры функцией input()
- преобразовывать число в строку функцией str
- склеивать из двух других строк операцией +.
Кроме того, мы умеем узнавать длину строки, используя функцию len, и проверять, является ли одна строка частью другой, используя операцию in:
Индексация в строках
В отличие от множеств, в строках важен порядок элементов (символов). Действительно, если множества {1, 2, 3} и {3, 2, 1} — это одинаковые множества, то строки МИР и РИМ — две совершенно разные строки. Наличие порядка дает нам возможность пронумеровать символы. Нумерация символов начинается с 0:
| H | E | L | L | O |
|---|---|---|---|---|
| 0 | 1 | 2 | 3 | 4 |
Индекс
По индексу можно получить соответствующий ему символ строки. Для этого нужно после самой строки написать в квадратных скобках индекс символа.
Естественно, в этом примере word с тем же успехом можно было считать с клавиатуры через input(). Тогда мы не могли бы заранее сказать, чему равны переменные initial_letter и other_letter.
А что будет, если попытаться получить букву, номер которой слишком велик? В этом случае Python выдаст ошибку:
Отрицательные индексы
Кроме «прямой» индексации (начинающейся с 0), в Python разрешены отрицательные индексы: word[-1] означает последний символ строки word, word[-2] — предпоследний и т д.
| 0 | 1 | 2 | 3 | 4 |
|---|---|---|---|---|
| H | E | L | L | O |
| -5 | -4 | -3 | -2 | -1 |
А можно ли, используя индексацию, изменить какой-либо символ строки? Давайте проверим:
Перебор элементов строки
В предыдущем уроке мы узнали, что цикл for можно использовать для перебора элементов множества. Таким же образом можно использовать цикл for, чтобы перебрать все буквы в слове:
Но, так как символы в строке пронумерованы, у нас есть еще один способ перебрать все элементы в строке: перебрать все индексы, используя уже знакомую нам конструкцию for i in range(...).
Хранение текста в памяти компьютера
Давайте немного поговорим о том, как строки хранятся в памяти компьютера. Поскольку компьютер умеет хранить только двоичные числа, для записи нечисловой информации (текстов, изображений, видео, документов) прибегают к кодированию. Самый простой случай кодирования — сопоставление кодов текстовым символам.
Один самых распространенных форматов такого кодирования — таблица ASCII (American standard code for information interchange).
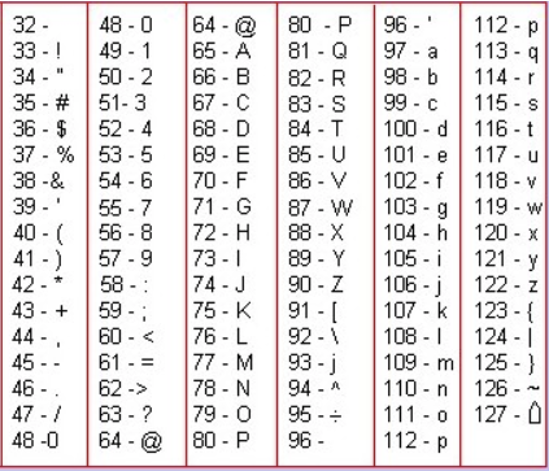
Изначально в этой таблице каждому символу был поставлен в соответствие 7-битный код, что позволяло идентифицировать 128 различных символов. В таблице вы не видите символы с кодами, меньшими 32, так как они являются служебными и не предназначены для непосредственного вывода на экран (пробел, перевод строки, табуляция и т. д.). Этого хватало на латинские буквы обоих регистров, знаки препинания и спецсимволы — например, перевод строки или разрыв страницы. Позже код расширили до 1 байта, что позволяло хранить уже 256 различных значений: в таблицу помещались буквы второго алфавита (например, кириллица) и дополнительные графические элементы (псевдографика).
В некоторых относительно низкоуровневых языках (например, в С) можно в любой момент перейти от представления строки в памяти к последовательности байтов, начинающейся по какому-либо адресу.
Сейчас однобайтные кодировки отошли на второй план, уступив место Юникоду.
Важно понимать, что Юникод — это не кодировка. Это именно таблица с описаниями элементов. То, как символы с соответствующими кодами будут храниться в памяти, зависит от конкретной кодировки, базирующейся на Юникоде: например, utf-8.
В Юникод все время добавляются новые элементы, а сам размер этой таблицы не ограничен и будет только расти, поэтому сейчас при хранении в памяти одного юникод-символа может потребоваться от 1 до 8 байт. Отсутствие ограничений привело к тому, что стали появляться символы на все случаи жизни. Например, есть несколько снеговиков. Этого вы можете увидеть, если наберете:
Важно понять, что все строки в Python хранятся именно как последовательность юникод-символов.
Функции ord() и chr()
Для того чтобы узнать код некоторого символа, существует функция ord (от order — «порядок»).
Зная код, всегда можно получить соответствующий ему символ. Для этого существует функция chr (от character — «символ»):
Функции ord и chr часто работают в паре. Попробуйте, например, предположить, что будет выведено на экран в результате работы следующей программы:
Срезы
Рассмотрим еще одну задачу. Билет называют счастливым по-питерски, если сумма цифр его номера, стоящих на четных местах, равна сумме цифр, стоящих на нечетных местах. Нам необходимо написать программу, которая определяет, является ли билет счастливым по-питерски.
Если рассматривать номер билета как строку из цифр, задача сводится к подсчету суммы цифр, стоящих на позициях 0, 2, 4..., и суммы цифр, стоящих на позициях 1, 3, 5.... Чтобы перебрать элементы, мы можем воспользоваться конструкцией for i in range(...), указав шаг 2. Тогда соответствующий фрагмент программы может выглядеть следующим образом:
Срезы строк
На примере разобранной задачи мы увидели, что перебор элементов строки с помощью конструкции for i in range(...) является достаточно гибким: можно перебрать не все индексы, можно идти с шагом, скажем, 2 или даже −1, то есть в обратном порядке. Но существует способ без всякого цикла преобразовать строку нужным образом: взять отдельный ее кусок, символы с нечетными номерами и т. д. Этот способ — срез (slice).
В самом простом варианте срез строки — ее кусок от одного индекса включительно и до другого не включительно (как для range). То есть это новая, более короткая строка.
Срез записывается с помощью квадратных скобок, в которых указывается начальный и конечный индекс, разделенные двоеточием.
Если не указан начальный индекс, срез берется от начала (от 0). Если не указан конечный индекс, срез берется до конца строки. Попробуйте предположить, что будет выведено на экран, если в предыдущей программе записать срезы следующим образом:
Разрешены отрицательные индексы для отсчета с конца списка. В следующем примере из строки, содержащей фамилию, имя и отчество, будет извлекаться фамилия.
Как «откусить» от строки первый символ? Последний символ?
Как и для range, в параметры среза можно добавить третье число — шаг обхода. Этот параметр не является обязательным и записывается через второе двоеточие. Вот как может выглядеть программа «Счастливый билет», если решать ее с помощью срезов:
Интересное отличие среза от обращения по индексу к отдельному элементу состоит в том, что мы не получим ошибку при указании границ среза за пределами строки. В срез в таком случае попадут только те элементы, которые находятся по валидным индексам среза:
Шаг может быть и отрицательным — для прохода по строке в обратном порядке. Если в этом случае не указать начальный и конечный индекс среза, ими станут последний и первый индексы строки соответственно (а не наоборот, как при положительном шаге):
Итак, с помощью квадратных скобок можно получить доступ как к одному символу строки, так и к некоторой последовательности символов, причем совсем необязательно идущих подряд!
Задачи
Часть 1: Индексация
Задача 1
Считайте слово и выведите его пятую букву (нумерация с 1). Если букв меньше пяти — выведите НЕТ.
Тест 1:
Ввод:
Вывод:Тест 2:
Ввод:
Вывод:Задача 2
Считайте слово и проверьте, начинается ли оно с буквы а (строчной русской). Выведите ДА или НЕТ.
Тест 1:
Ввод:
Вывод:Тест 2:
Ввод:
Вывод:Задача 3
Считайте слово и выведите его последнюю букву.
Тест 1:
Ввод:
Вывод:Задача 4
Считайте два слова. Проверьте, совпадает ли последний символ первого слова с первым символом второго. Выведите ВЕРНО или НЕВЕРНО.
Тест 1:
Ввод:
Вывод:Тест 2:
Ввод:
Вывод:Задача 5
Выведите слово вертикально — по одной букве в строке.
Тест 1:
Ввод:
Вывод:Задача 6
Считайте букву по номеру из сообщения (нумерация с 1). Если номер выходит за пределы строки — выведите ОШИБКА.
Тест 1:
Ввод:
Вывод:Тест 2:
Ввод:
Вывод:Задача 7
Считайте строку и выведите Unicode-коды всех её символов через запятую с пробелом.
Тест 1:
Ввод:
Вывод:Задача 8
Считывайте слова до тех пор, пока первая буква нового слова совпадает с последней буквой предыдущего. Выведите слово, которое нарушило правило.
Тест 1:
Ввод:
Вывод:Задача 9
Считайте строку и выведите количество гласных букв в ней (а е ё и о у ы э ю я).
Тест 1:
Ввод:
Вывод:Тест 2:
Ввод:
Вывод:Задача 10
Реализуйте шифр Цезаря для русского алфавита. Считайте шаг сдвига и строку. Сдвиньте каждую русскую букву на указанное число позиций по алфавиту (циклически). Прочие символы не изменять.
Алфавит: абвгдеёжзийклмнопрстуфхцчшщъыьэюя (33 буквы)
Тест 1:
Ввод:
Вывод:Тест 2:
Ввод:
Вывод:Часть 2: Срезы
Задача 11
Считайте строку и выведите её в обратном порядке.
Тест 1:
Ввод:
Вывод:Задача 12
Считайте строку и выведите первые 3 символа и последние 3 символа через пробел.
Тест 1:
Ввод:
Вывод:Тест 2:
Ввод:
Вывод:Задача 13
Считайте строку. Если она начинается с Не или не — удалите это начало и выведите результат. Иначе выведите строку без изменений.
Тест 1:
Ввод:
Вывод:Тест 2:
Ввод:
Вывод:Задача 14
Считайте число n и выведите каждый второй символ строки начиная с первого (индекс 0).
Тест 1:
Ввод:
Вывод:Задача 15
Считайте n — максимальную длину анонса — и строку. Если строка длиннее n символов, обрежьте её до n-3 символов и добавьте .... Иначе выведите как есть.
Тест 1:
Ввод:
Вывод:Тест 2:
Ввод:
Вывод:Задача 16
Считайте строку. Проверьте, является ли она палиндромом (читается одинаково слева направо и справа налево). Выведите ДА или НЕТ.
Тест 1:
Ввод:
Вывод:Тест 2:
Ввод:
Вывод:Задача 17
Игра "Быки и коровы". Считайте два слова одинаковой длины. Выведите количество быков (одинаковые символы на одинаковых позициях) и коров (одинаковые символы на разных позициях).
Тест 1:
Ввод:
Вывод:Задача 18
Считайте строку. Найдите максимальную длину непрерывной последовательности одинакового символа.
Тест 1:
Ввод:
Вывод:Тест 2:
Ввод:
Вывод:Задача 19
Считайте n строк. Выведите строки, обработав их по правилам:
- Если строка начинается с %% — удалить эти символы и вывести остаток
- Если строка начинается с #### — пропустить (не выводить)
- Иначе — вывести как есть
Тест 1:
Ввод:
Вывод:Задача 20
Считайте имя пользователя и проверьте, что оно состоит только из латинских букв, цифр и знака _. Если всё верно — выведите OK. Иначе — выведите Неверный символ: [символ] для первого недопустимого символа.
Тест 1:
Ввод:
Вывод:Тест 2:
Ввод:
Вывод: